
Un token, c’est quoi ?
Comprendre les tokens, leur coût et ce qu’ils représentent concrètement.
Un e-mail à reformuler, un document à résumer, une idée à creuser… Vous utilisez peut-être l’IA chaque jour sans vous poser la question. Pourtant, derrière chaque échange, une unité revient : le token.
À quoi correspond-il ? Combien en faut-il pour un texte ? Et pourquoi en parle-t-on dans les tarifs ? Voici les repères pour y voir plus clair.
C’est quoi, un token ?
Un token est un petit morceau de texte utilisé par un modèle d’IA. Il peut correspondre à un mot entier, une partie de mot ou un signe de ponctuation. Les espaces comptent aussi dans le découpage.
Le modèle traite le texte sous forme de tokens, dont le découpage peut sembler surprenant. Il en génère ensuite pour construire sa réponse.
Comment ça se découpe ?
Le plus simple est de regarder quelques exemples :
| Texte | Découpage | Tokens |
|---|---|---|
| Bonjour | Bonjour | 1 |
| Intelligence artificielle | Intelligence·artificielle | 6 |
| Hello world | Hello·world | 2 |
Le découpage peut varier selon le modèle. Le point médian « · » représente un espace. Compter les tokens de votre texte.
« Bonjour » tient ici dans un seul token. « Intelligence artificielle », pourtant composé de deux mots, en utilise six. Compter les mots ne suffit donc pas à compter les tokens.
1 000 tokens, ça représente combien de texte ?
Le repère souvent utilisé : 1 token ≈ 4 caractères, soit environ ¾ de mot en anglais.
C’est une estimation. En français, un contenu équivalent peut demander davantage de tokens, selon le modèle. Les chiffres ci-dessous restent donc des repères, pas une conversion exacte.
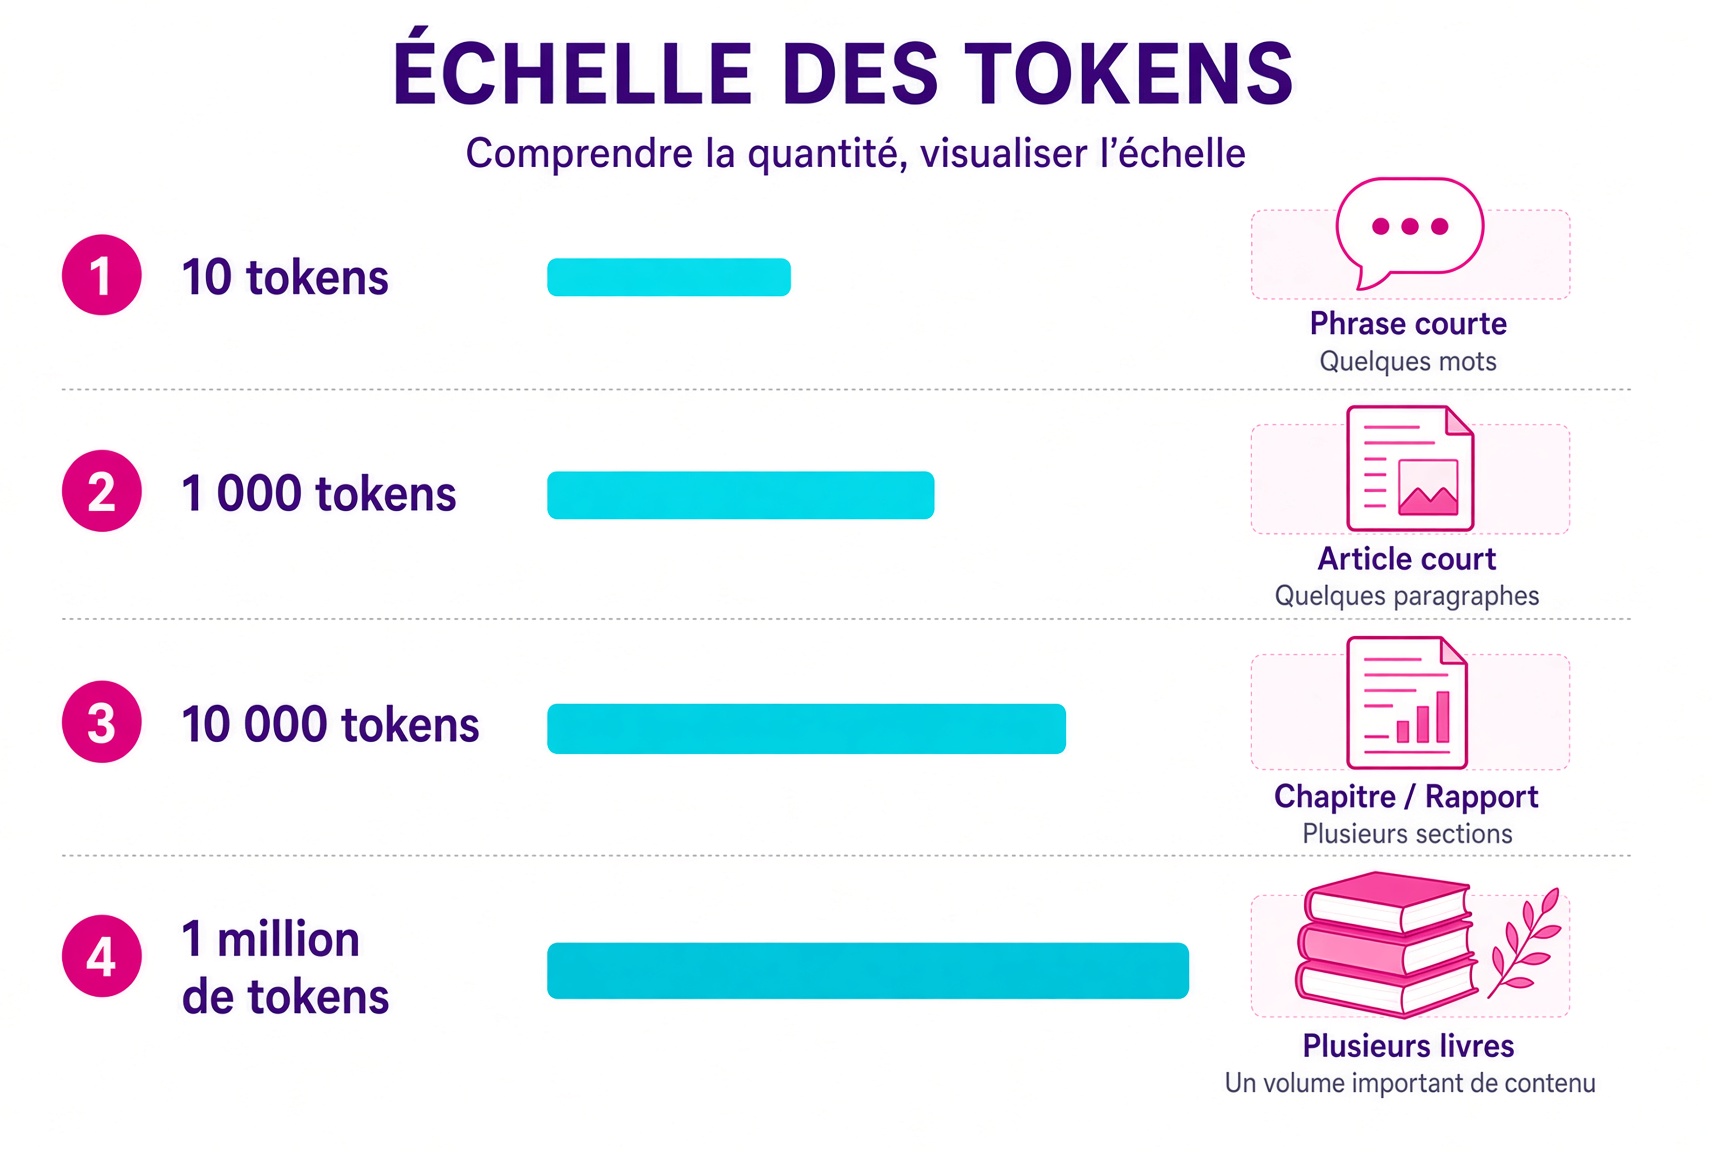
Pour visualiser les volumes, voici ce que donne ce repère anglais :
| Volume | Équivalent approximatif (anglais) | Pour se représenter |
|---|---|---|
| 10 tokens | 7 à 8 mots | Une courte phrase |
| 1 000 tokens | 750 mots | Un article court |
| 10 000 tokens | 7 500 mots | Un chapitre ou un rapport |
| 1 million de tokens | 750 000 mots | Plusieurs romans |
Ces équivalences donnent une échelle, pas une capacité garantie. Un million de tokens peut être consommé sur de nombreux échanges ; cela ne signifie pas qu’un modèle accepte tout ce texte en une seule fois.
Entrée et sortie : deux compteurs à distinguer
Vous joignez un document et demandez :
« Peux-tu résumer ce document en cinq points ? »
Les tokens d’entrée : votre question et le contenu du document transmis, mais aussi les instructions de l’application et l’historique éventuellement inclus.
Les tokens de sortie : ce que le modèle génère pour répondre, notamment les cinq points du résumé.
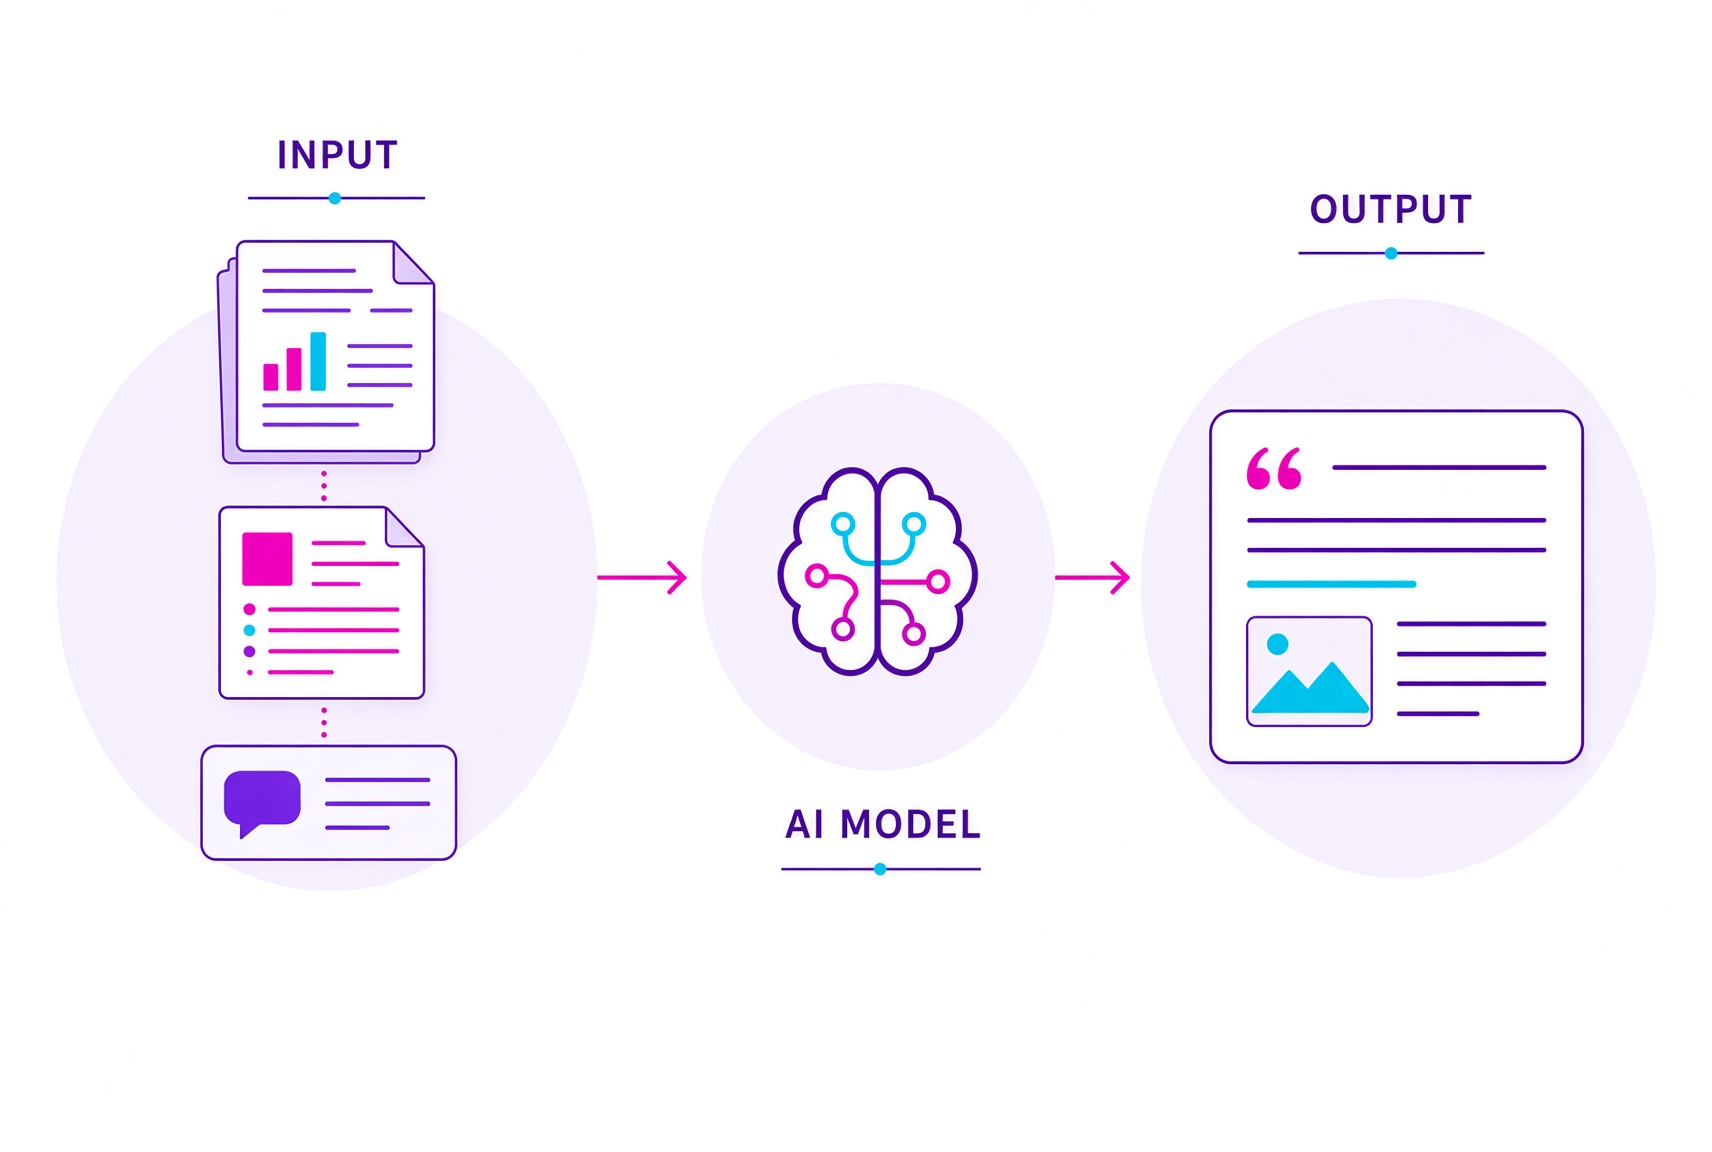
Votre question ne fait que quelques mots, mais l’ensemble envoyé peut représenter des milliers de tokens. Si vous poursuivez la conversation, des échanges précédents peuvent être transmis à nouveau pour conserver le contexte.
Certains modèles utilisent aussi des tokens de raisonnement internes, non visibles dans la réponse, qui peuvent entrer dans le décompte de sortie.
Et ça coûte combien ?
Dans une offre facturée à la consommation, le tarif dépend du modèle choisi. Il est souvent affiché par million de tokens, avec un prix pour l’entrée et un autre pour la sortie. La sortie est souvent plus chère, mais il n’existe pas de multiplicateur universel.
Quel modèle pour quel usage ?
Voici quatre exemples pour comparer les prix et les usages à envisager. Les indications d’usage sont des pistes de sélection fondées sur le positionnement des fournisseurs, à tester sur vos propres documents.
Tarifs publics relevés le 20 octobre 2026, en dollars US par million de tokens. Accès direct par API — l’interface qui permet à une application d’utiliser le modèle — en tarification standard, pour du texte, sans remise de cache ni traitement par lots. Pour GPT-6.1 Sol, tarifs jusqu’à 272 000 tokens d’entrée. Hors taxes éventuelles, options régionales, outils et frais de plateforme. Il ne s’agit ni des prix des abonnements grand public, ni des tarifs AIFlow.
| Modèle | Entrée / 1 M | Sortie / 1 M | Usages à envisager |
|---|---|---|---|
| Gemini 3.5 Flash-Lite | 0,30 $ | 2,50 $ | Traduire des contenus, classer des demandes et traiter des données simples en volume. |
| GPT-6.1 Sol OpenAI | 2,00 $ | 10,00 $ | Analyser des dossiers, réaliser des tâches professionnelles complexes et développer du code. |
| Claude Sonnet 5.5 Anthropic | 2,00 $ | 10,00 $ | Tester un compromis entre rapidité et capacité d’analyse pour des tâches variées. |
| Claude Opus 5.5 Anthropic | 4,00 $ | 20,00 $ | Mener des travaux documentaires ou de développement longs, avec plusieurs étapes. |
Sources tarifaires : Google, OpenAI et Anthropic. Les tarifs peuvent évoluer.
Combien pour un même volume de tokens ?
Prenons 10 000 tokens en entrée et 2 000 tokens facturés en sortie par échange. Pour chacun des modèles, le calcul est le même : 0,01 × le tarif d’entrée + 0,002 × le tarif de sortie.
| Modèle | Un échange | 1 000 échanges |
|---|---|---|
| Gemini 3.5 Flash-Lite | 0,008 $ | 8,00 $ |
| GPT-6.1 Sol | 0,040 $ | 40,00 $ |
| Claude Sonnet 5.5 | 0,040 $ | 40,00 $ |
| Claude Opus 5.5 | 0,080 $ | 80,00 $ |
Dans cet exemple, la consommation de tokens représente donc de 8 à 80 $ pour 1 000 échanges. Le tarif unitaire devient particulièrement important lorsque les équipes multiplient les usages.
Simulation à volumes identiques, pas mesure du coût d’une tâche réelle : les modèles peuvent découper le même texte différemment et générer des quantités différentes de réponse ou de raisonnement. Les 2 000 tokens de sortie incluent ici tout raisonnement facturé. Les éventuels appels à des outils s’ajoutent au calcul.
Le bon modèle est celui qui fait bien le travail demandé.
Commencez par tester une option économique sur une tâche précise. Si la qualité ne suffit pas, comparez avec un modèle plus avancé. Pour des documents sensibles, examinez aussi les conditions de traitement des données.
Avec un abonnement mensuel à une application, vous ne payez pas nécessairement chaque échange au token : l’offre possède ses propres fonctionnalités et limites d’usage.
Pourquoi l’IA perd-elle parfois le fil ?
Un modèle dispose d’une « fenêtre de contexte » : la quantité d’informations qu’il peut traiter à la fois. Si les documents et la conversation prennent trop de place, l’application peut devoir résumer ou écarter certains éléments. Ce n’est toutefois pas la seule cause possible d’une mauvaise réponse.
Les bons réflexes pour maîtriser sa consommation
- Ouvrez une nouvelle conversation lorsque vous changez de sujet. Selon l’application, une partie des échanges précédents est retransmise au modèle pour conserver le contexte. Une longue conversation peut donc augmenter le volume traité, même si votre dernière question tient en une ligne.
- Donnez une consigne claire, avec la longueur attendue. « Résume les décisions et les actions à mener en cinq points » évite plus facilement les allers-retours qu’un simple « résume ». Une réponse détaillée est utile quand le sujet le demande ; quelques lignes peuvent suffire pour une question précise.
- Transmettez le contexte utile. Parfois, tout le document est nécessaire. Parfois, le passage concerné suffit.
- Choisissez un modèle adapté, si l’outil le permet. Une reformulation simple ne demande pas forcément le même modèle qu’une analyse complexe. Vérifiez surtout la qualité du résultat.
- Suivez les usages dans la durée. Le volume des documents, la longueur des échanges et le nombre d’utilisateurs comptent autant que le tarif affiché.
À retenir : un token est un morceau de texte, pas forcément un mot. On distingue ce que l’IA reçoit de ce qu’elle génère. Comprendre ces deux volumes aide à mieux lire les offres et à anticiper ses usages.